

Há poucos lugares mais perigosos para um praticante de tsundoku (a nobre arte japonesa de acumular livros na pilha de leitura) quanto aqueles onde livros são oferecidos com descontos generosos. É o caso da Festa do Livro da USP, evento que é promovido pela Editora da USP desde 1999. O requisito para uma editora participar do evento é oferecer um desconto de, no mínimo, 50%.
Este ano ela vai acontecer entre 25 e 29 de novembro, reunindo 245 editoras dos mais diversos segmentos (todas nacionais). Algumas editoras que eu gostaria que participassem infelizmente não aparecem. Então, se o alvo são livros em outra língua ou editados fora do Brasil, a coisa muda de figura.
Mas mesmo considerando “apenas” as editoras brasileiras, os números já são intimidadores. E eu nem estou falando do número de editoras, títulos disponíveis ou pessoas que visitam o evento. Estou falando dos números que passam pela minha cabeça quando começo a pensar em todos os livros que eu posso conseguir.
Trata-se do tipo de evento onde não é nada recomendável entrar casualmente procurando um título qualquer. Para algumas pessoas, quase dá pra dizer que é um lugar traiçoeiro, cheio de “armadilhas”. Então, naturalmente, uma ocasião dessas exige planejamento, senão o estrago pode ser bem grande.
O problema
O site oficial da feira disponibiliza uma lista de editoras, com listas de livros de cada uma, e um sistema de busca integrada, incluindo os preços de cada livro. Dá pra dizer que é uma ferramenta útil, se estamos procurando algo específico.
Em 2023 alguma boa alma conseguiu juntar os PDFs com as listas de livros de cada editora, o que, em alguns casos, já é muito superior ao sistema do site. Um único documento que podemos ir olhando aos poucos, e pescando coisas interessantes já é bem melhor que um site que só permite ver um certo número de entradas por vez, de um universo de dezenas de milhares de títulos.
Mas um PDF gigante está longe de ser a forma mais eficiente de fazer isso. Um planejamento adequado exige ferramentas mais apropriadas. Ou, falando bom português, precisamos de uma planilha. Então, em 2024 eu resolvi tentar fazer algo um pouco mais útil: juntar tudo em uma planilha, para planejar minha passagem pela feira e, dessa forma, evitar “acidentes”.
Só que isso esbarra em um problema: por algum motivo obtuso que eu sou incapaz de sequer imaginar, o site da feira dificulta muito o processo. A lista de livros não é “visível” da forma normal, que seria uma tabela com as entradas que alguém com paciência poderia simplesmente baixar e compilar. Não, não; as mentes brilhantes que gerenciam o site resolveram usar JavaScript – essa aberração enviada por Belzebu – para esconter o conteúdo atrás de algumas camadas de execução dinâmica (pra quê usar o tempo de CPU do servidor se eles podem usar o de quem visita o site?). Nada faz sentido – o HTML do site não funciona como deveria, porque está todo ancorado em scripts que carregam o conteúdo dinamicamente.
Python to the rescue
Uma pessoa menos motivada poderia dar de ombros. Mas não eu.
Não vou dizer que me senti “desafiado”. Seria uma palavra interessante para descrever um problema que leva alguém a criar uma solução criativa. Mas, no meu caso, acho que a palavra mais apropriada é “desaforado”.
A essa altura, mesmo que eu não fosse tão aficionado por livros, eu entraria nessa empreitada só por pirraça. A informação deve ser livre, e ser acessível ao maior número possível de pessoas. Essa abordagem maluca de ofuscar o conteúdo do site atrás de um script me deixou puto.
Alguém já disse alguma vez que a maior força motriz da humanidade é a pirraça.
Essa pessoa não estava errada.
Então lá fui eu, tentar exercitar uma vez mais o músculo do Python para tentar desvendar essa maluquice. O primeiro desafio era conseguir os dados.
O que o navegador não mostra
Embora as informações estejam disponíveis no site oficial, aquilo que aparece numa página do navegador nem sempre corresponde ao que está diretamente disponível no código HTML. Parte do conteúdo é carregada dinamicamente via JavaScript.
Felizmente, toda faca tem dois gumes: o próprio site utiliza uma API – uma interface de programação — para consultar o catálogo. Os resultados são disponibilizados em JSON, um formato estruturado que pode ser processado pelo script com relativa facilidade.
Isso significa que, quando acessamos a página, nem todos os dados estão necessariamente presentes no documento recebido pelo navegador. Uma parte deles é solicitada posteriormente, processada pelos scripts e só então apresentada ao usuário.
Para quem está simplesmente navegando no site, tudo parece funcionar normalmente. Para alguém tentando extrair automaticamente milhares de registros, a coisa muda de figura.
O segredo foi descobrir quais requisições estavam sendo feitas e quais parâmetros eram necessários para obter os resultados. Para isso, a gente pode usar as próprias ferramentas do navegador. Ele pode mostrar toda a comunicação feita com o servidor onde o site está hospedado, o que nos dá acesso a informações como, por exemplo, o endpoint https://festadolivro.edusp.com.br/api/v1/event-books, responsável por retornar registros de livros, em um formato chamado JSON (JavaScript Object Notation). Apesar do nome, não precisamos usar JavaScript pra trabalhar com ele (felizmente).
Juntando as peças
Usando a biblioteca requests, podemos fazer uma requisição e ir baixando, aos poucos, a tabela inteira. Seria um tanto absurdo exigir que o servidor devolvesse dezenas de milhares de livros numa única resposta, então os resultados são divididos em páginas.
Isso não chega a ser um problema. Basta fazer uma requisição para cada página, armazenar os registros recebidos e continuar até chegar ao final.
Na teoria.
Na prática, também precisamos garantir que a paginação esteja funcionando corretamente, que nenhuma página seja repetida, que a coleta não termine prematuramente e que os registros não sejam duplicados.
Uma das precauções que incluí no programa foi calcular uma espécie de impressão digital de cada registro, utilizando o algoritmo SHA-256. Assim, podemos identificar registros idênticos e evitar que apareçam repetidamente no catálogo compilado.
assinatura = hashlib.sha256(
    json.dumps(livro, ensure_ascii=False, sort_keys=True).encode("utf-8")
).hexdigest()

if assinatura not in vistos:
    vistos.add(assinatura)
    registros.append(livro)
Sim, eu sei. Estamos usando uma função de hash criptográfico para organizar uma lista de compras. Talk about overkill.
Como eu disse, um projeto perfeitamente normal.
Para essa tarefa, o programa percorre os registros e converte os campos em colunas, preservando as informações recebidas sempre que possível.
Finalmente, os dados são exportados para um arquivo CSV (Comma-Separated Values), que pode ser importado por qualquer programa de planilhas.
with arquivo.open("w", encoding="utf-8-sig", newline="") as fp:
    writer = csv.DictWriter(
        fp, fieldnames=colunas, delimiter=";"
    )
    writer.writeheader()
    writer.writerows(linhas)
Aqui também temos alguns detalhes importantes. O arquivo é gravado em UTF-8, preservando os caracteres acentuados, e utiliza o ponto e vírgula como separador entre colunas — algo particularmente conveniente quando precisamos lidar com números decimais escritos com vírgula.
Hoje em dia isso pode parecer mais corriqueiro, mas quando eu aprendi a programar o UTF ainda não era tão difundido, e era bem comum encontrar problemas por causa de codificações diferentes (cansei de ler email com “mojibake” por causa disso).
Agora já tínhamos algo concreto: um arquivo com os registros do catálogo, pronto para ser importado e organizado numa planilha.
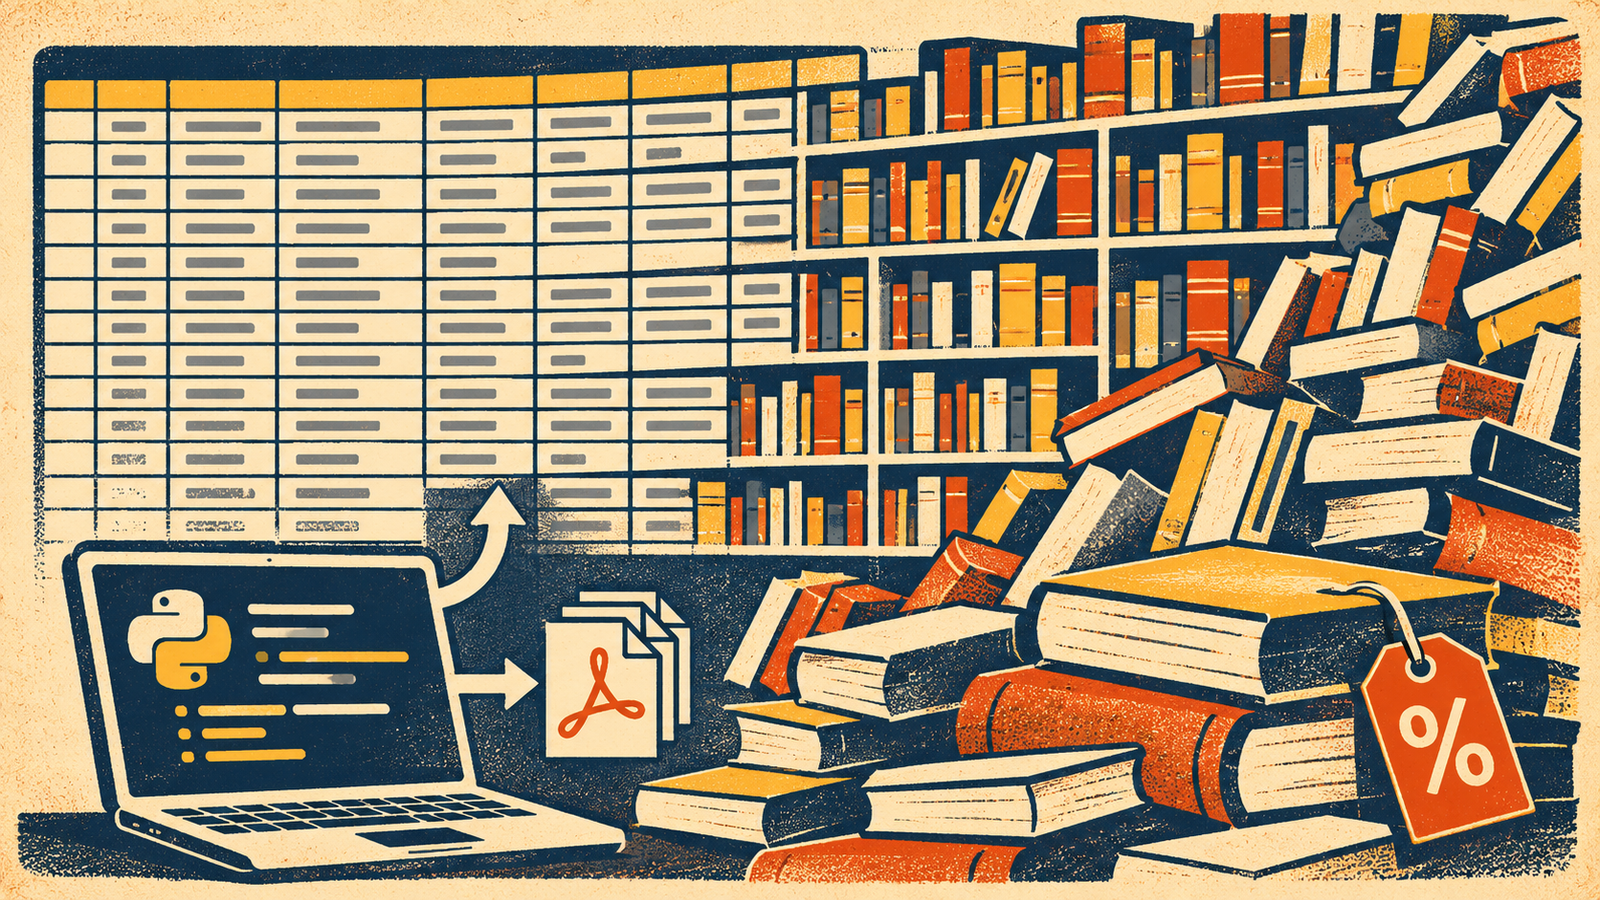
A partir daí, o trabalho consistiu em adaptar um programa em Python para consultar os dados, percorrer as páginas de resultados, reunir os registros e exportá-los para um arquivo CSV, que poderia ser importado para uma planilha do Google.
A planilha
O resultado de tudo isso é uma planilha que contém os dados compilados a partir de buscas feitas no site, com ISBN, autor, título, editora, preço e outras informações que podem ser relevantes. Assim, a consulta fica trivial, e a planilha também permite que qualquer pessoa possa montar a sua própria lista de compras sem precisar ficar refazendo busca atrás de busca no site.
Ela está aqui (e tem também links para o PDF agregado e os PDFs individuais de cada editora – ver adiante).
DISCLAIMER: os dados são obtidos a partir do site oficial da Festa do Livro da USP e disponibilizados no estado em que se encontram. A planilha é uma iniciativa independente, sem vínculo com a organização do evento, e deve ser utilizada apenas como ferramenta auxiliar de consulta.
Fica o disclaimer aí em cima, afinal a ideia é facilitar as coisas e nada mais. Vale mencionar também que o catálogo pode mudar e a planilha vai ser atualizada sempre que possível; nem todas as editoras já postaram seus catálogos, e pode acontecer de um livro esgotar durante a Festa. Na dúvida, vale a pena consultar o site diretamente.
Mas calma, ainda tem mais
Seria razoável imaginar que, a essa altura, o problema estivesse resolvido.
Seria.
Mas lembrei das listas de preços fornecidas individualmente pelas editoras. O próprio site avisa que a busca integrada considera apenas os catálogos já disponibilizados, de modo que ela não representa necessariamente tudo o que estará à venda durante o evento.
Além disso, as listas em PDF podem conter informações que não aparecem na busca integrada.
Então surgiu uma ideia PERFEITAMENTE SENSATA: já que havia conseguido extrair o catálogo, por que não aproveitar para reunir também os PDFs das editoras?
Naturalmente, assim como os livros do catálogo, os links pra baixar os PDFs de cada editora estavam cOnVeNiEnTeMeNte ofuscado por mais algumas camadas de JavaScript. Abri o painel de desenvolvedor do navegador de novo e encontrei outro endpoint da API: https://festadolivro.edusp.com.br/api/v1/event-publishers.
Nesse caso, o servidor fornece informações sobre as editoras, incluindo seus nomes, endereços de suas páginas individuais e, quando disponíveis, os links para seus arquivos de listas de preços.
Mais uma vez, os dados são paginados. Mais uma vez, precisamos percorrer os registros. E, naturalmente, mais uma vez surgiu a oportunidade de escrever outro programa.
Dessa vez, a ideia era obter os endereços dos PDFs, baixar tudo e organizar num diretório, identificando cada arquivo pela editora correspondente. Também seria necessário lidar com links ausentes, arquivos duplicados e eventuais falhas nos downloads.
E foi exatamente o que fizemos.
O programa percorre os registros das editoras, identifica os endereços das listas de preços e baixa os arquivos disponíveis. Para evitar surpresas desagradáveis, também verifica se os arquivos recebidos são realmente PDFs, ignora documentos já baixados e gera um relatório com o resultado de cada operação (outra planilha!).
Uma das funções mais simples do programa ilustra bem essa preocupação:
def arquivo_pdf_valido(caminho):
    if not caminho.is_file():
        return False
    with caminho.open("rb") as arquivo:
        return arquivo.read(5) == b"%PDF-"
O teste verifica se o arquivo começa com uma checagem mínima de sanidade da assinatura característica de um PDF. Afinal, não seria a primeira vez que um servidor engraçadinho devolveria uma página de erro no lugar do documento solicitado, deixando um arquivo aparentemente legítimo para descobrirmos a surpresa depois.
No fim, conseguimos reunir automaticamente as listas de preços disponibilizadas pelas editoras, sem precisar abrir centenas de páginas e baixar cada documento manualmente.
Uma questão de prioridades
Parece bastante simples quando resumido assim. Evidentemente, isso ignora os pequenos detalhes que costumam consumir boa parte do tempo de qualquer projeto de programação: campos ausentes, paginação, registros repetidos, formatação de preços e todas aquelas pequenas particularidades que nos fazem questionar por que não decidimos simplesmente largar essa tarefa pra lá e ir fazer alguma outra coisa mais interessante.
Mas a pirraça não deixa. Pra não falar da minha própria natureza obsessiva.
De repente, aquilo que deveria ser apenas uma lista de compras já envolvia requisições HTTP, APIs, arquivos JSON, scripts em Python, PDFs e uma quantidade bastante questionável de tempo investido.
Em outras palavras, um projeto perfeitamente normal para uma quinta à tarde (preso em casa pra não contaminar as pessoas — temos um caso de COVID aqui em casa).
Aquela pessoa que chega a este blog casualmente, dotada de um nível de sanidade maior que o meu, pode se perguntar se realmente vale a pena dedicar esse esforço todo só pra montar uma planilha.
É uma pergunta perfeitamente legítima e razoável, para a qual eu não pretendo dar uma resposta muito elaborada.
Afinal, existe uma contradição bastante evidente em passar horas programando uma ferramenta destinada a economizar tempo. Especialmente quando o objetivo final é comprar mais livros do que provavelmente conseguiremos ler.
Por outro lado, há alguma satisfação em transformar um pequeno problema cotidiano em uma oportunidade de aprender, experimentar ferramentas e produzir algo que eventualmente possa ser útil para outras pessoas. Sem falar que o processo todo é, por si só, uma forma peculiar de entretenimento. É divertido resolver o quebra-cabeça que o problema propõe.
E, se a planilha ajudar alguém a encontrar um livro interessante, comparar algumas opções ou simplesmente organizar melhor sua visita à Festa, já terá cumprido uma função bastante razoável.
Quanto a mim, ainda preciso decidir quais livros comprar.
O que, curiosamente, era o problema original.